Komunikacja przemysłowa: praktyczny przewodnik dla zakładów produkcyjnych
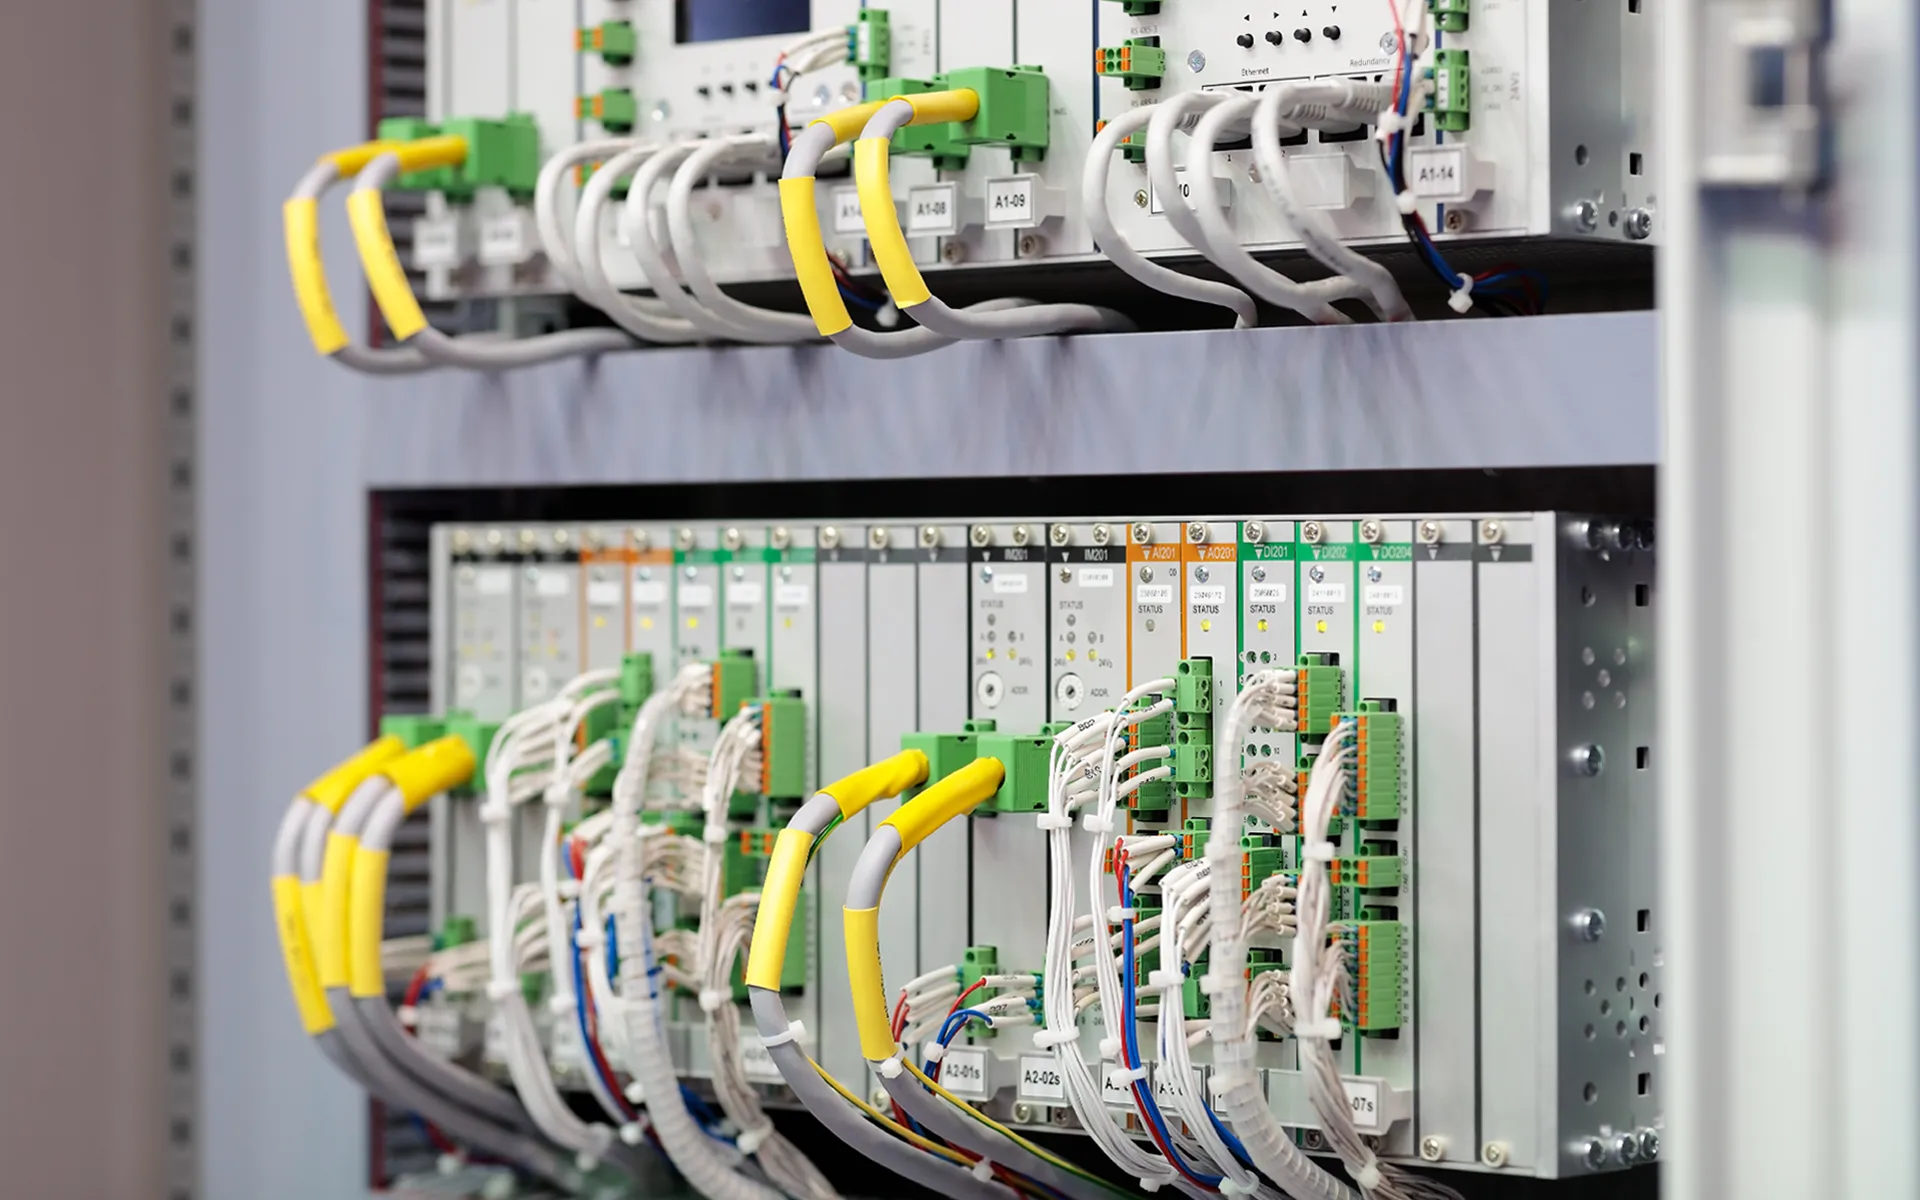
Nowa linia lakiernicza w zakładzie automotive rusza w poniedziałek. W piątek dashboard OEE przestaje się odświeżać na drugiej zmianie. Linia produkuje, tylko dane, które to potwierdzają, nie docierają. Przyczyną okazują się trzy stare sterowniki PLC, których nikt porządnie nie podłączył do warstwy danych.
Mała historia, duży problem. Dopóki tych danych nie ma, produkcja nie widzi, jak pracuje linia, utrzymanie ruchu wchodzi w kolejną zmianę na ślepo, a kontroling liczy wydajność zmian ręcznie. Każda z tych rzeczy kosztuje. Razem tłumaczą, dlaczego komunikacja przemysłowa zeszła z listy zaległości IT i trafiła na agendę zarządów średnich i dużych firm produkcyjnych.
Komunikacja przemysłowa to warstwa integracji, dzięki której maszyny, czujniki, sterowniki i systemy IT na hali wymieniają dane operacyjne niezawodnie i w ustandaryzowanej formie, niezależnie od producenta i protokołu. Dla zakładów z branży automotive, lotniczej, farmaceutycznej czy dóbr konsumpcyjnych to podstawa decyzji w czasie rzeczywistym, predykcyjnego utrzymania ruchu, zgodności z regulacjami i kontroli kosztów. Ten przewodnik wyjaśnia, czym jest komunikacja przemysłowa, gdzie projekty wykładają się na starym sprzęcie i podziale IT/OT oraz które protokoły i technologie mają znaczenie. Dalej pokazuje, jak oceniać dostawców, policzyć business case i ułożyć wdrożenie tak, żeby obsłużyło przypadki użycia Przemysłu 4.0 i IIoT, zamiast dołączyć do długiej listy zatrzymanych pilotaży.
Czym naprawdę jest komunikacja przemysłowa
Komunikacja przemysłowa to zintegrowanie urządzeń, maszyn i oprogramowania na hali produkcyjnej w taki sposób, żeby dane płynęły między nimi w standardowej, użytecznej postaci. Leży pod każdą inicjatywą smart factory, obojętnie jak nazwie ją broszura.
W praktyce łączy cztery grupy sprzętu. Na dole aparaturę obiektową: czujniki, napędy, skanery. Wyżej sterowniki: PLC, DCS, CNC. Nad nimi systemy nadzoru: SCADA, HMI, historian. Na szczycie IT przedsiębiorstwa: MES, ERP, analitykę, chmurę. Zadaniem warstwy komunikacji jest sprawić, żeby te cztery grupy rozmawiały ze sobą bez pisania tego samego translatora po raz drugi.
Od sieci biurowej odróżnia ją środowisko. Sprzęt musi znosić ciepło, wibracje, pył i zakłócenia elektromagnetyczne, a dane są operacyjne: bieżące wartości procesu, alarmy i stany maszyn, na których podstawie decyzje zapadają w sekundach, a nie po kwartalnym przeglądzie.
Dlaczego zarząd zaczął o to pytać
Trzy rzeczy przeniosły ten temat z działu automatyki do sali zarządu.
Programy cyfryzacji regularnie wykładają się na warstwie łączności. Badanie McKinsey prowadzone z Global Lighthouse Network Światowego Forum Ekonomicznego pokazało, że co najmniej 70 % producentów tkwi w czyśćcu pilotaży: inicjatywy cyfrowe sprawdzają się w pilocie i nigdy nie skalują na całą sieć zakładów.
Zespół operacyjny McKinsey nazywa przyczynę ostatnią milą IT/OT i zwraca uwagę, że typowy średni zakład ma ponad 200 urządzeń od różnych dostawców, każde z własną platformą i protokołem. Pilot predykcyjnego utrzymania ruchu, który działa na 50 tagach, zatrzymuje się na 50 000 tagów w trzech zakładach. Model nie jest problemem. Problemem jest hydraulika danych. Zarząd, który zatwierdził jedną rundę inwestycji cyfrowych i nie zobaczył zwrotu, przed kolejną zadaje trudniejsze pytania.
Koszt złej łączności da się zmierzyć. Raport Siemensa True Cost of Downtime 2024 szacuje straty z nieplanowanych przestojów w 500 największych firmach świata na około 1,4 biliona dolarów rocznie, czyli 11 % przychodów, wobec 8 % w 2019 roku. W automotive stojąca linia kosztuje do 2,3 mln dolarów za godzinę. Z badania ABB Value of Reliability wynika, że dwie trzecie firm przemysłowych mierzy się z nieplanowanym przestojem co najmniej raz w miesiącu, a typowy koszt to około 125 000 dolarów za godzinę.
Znaczna część tych przestojów bierze się z danych, których zespół potrzebował, ale nie dostał na czas. Zakład, który na pytanie „dlaczego w zeszłym tygodniu spadł uzysk na linii 3” odpowiada po dwóch dniach śledztwa, podejmuje każdą decyzję operacyjną wolniej i drożej, niż musi. Zakłady, które odpowiadają w minuty, skracają MTTR, poprawiają uzysk za pierwszym przejściem i uwalniają czas inżynierów na pracę, która się kumuluje.
Klienci i regulatorzy pytają. Duzi odbiorcy z automotive i farmacji wymagają dziś od dostawców udokumentowanego cyberbezpieczeństwa, identyfikowalności i kontroli nad wymianą danych. W Unii dochodzi regulacja: dyrektywa NIS2, w Polsce wdrażana nowelizacją ustawy o krajowym systemie cyberbezpieczeństwa (KSC). O tym, co NIS2 oznacza dla sieci OT, piszemy osobno. Gdziekolwiek działasz, zakład, który nie potrafi pokazać audytowalnego przepływu danych od maszyny do chmury, przegrywa przetargi, które kiedyś wygrywał ceną.
Jak działa komunikacja przemysłowa?
Komunikacja przemysłowa działa tak: oprogramowanie pośredniczące (middleware) tłumaczy zamknięte protokoły urządzeń na wspólny format, a potem przekazuje dane do systemów wyższego poziomu przez ustandaryzowane, niezależne od producenta interfejsy. Jeden punkt integracji zamiast osobnego sterownika dla każdego systemu.
Na poziomie obiektowym urządzenia mówią dialektem, który wybrał producent: Modbus TCP, EtherNet/IP, PROFINET, IO-Link i dziesiątki innych. Platforma komunikacyjna uruchamia sterowniki, które tłumaczą każdy dialekt na jeden wewnętrzny model danych, a następnie udostępnia go w górę przez dwa neutralne standardy: OPC UA dla przemysłowej wymiany klient–serwer oraz MQTT ze Sparkplug B dla modelu publikuj–subskrybuj i chmury. Przez te same interfejsy roboty, obrabiarki CNC i inne zautomatyzowane urządzenia publikują swój stan obok reszty linii, więc systemy wyżej widzą jeden spójny obraz zamiast tuzina silosów.
Efekt: SCADA, MES, historian i analityka w chmurze czerpią te same dane z hali przez jeden punkt integracji, zamiast każdy utrzymywać własną bibliotekę sterowników. To rozprzęgnięcie jest całym argumentem ekonomicznym. IT i OT przestają kłócić się o dostęp do danych i zaczynają je współdzielić.
Sześć protokołów, które pokrywają 90 % hali
| Protokół | Warstwa | Typowe zastosowanie |
|---|---|---|
| Modbus TCP / RTU | urządzenia | starsze PLC, napędy, liczniki energii |
| EtherNet/IP | urządzenia, sterowniki | ekosystem Allen-Bradley / Rockwell |
| PROFINET | urządzenia, sterowniki | Siemens i ekosystemy europejskie |
| IO-Link | czujniki | inteligentne czujniki i elementy wykonawcze |
| OPC UA | warstwa danych | neutralna wymiana OT/IT |
| MQTT (Sparkplug B) | warstwa IIoT | edge–chmura, Unified Namespace |
Sześć protokołów pokrywa mniej więcej 90 % typowej hali. Pierwsze cztery obsługują krótkie rozmowy między sterownikami a urządzeniami. OPC UA i MQTT przenoszą dane z kontekstem przez granicę OT/IT. Nowoczesne architektury używają obu, a platforma komunikacyjna pośrodku zajmuje się tłumaczeniem.
W warstwie transportowej domyślny pozostaje Ethernet przemysłowy, z łączami gigabitowymi dla aplikacji wrażliwych na opóźnienia. Tam, gdzie kabel nie ma sensu, wchodzi transmisja bezprzewodowa (prywatne 5G, Wi-Fi 6), a przetwarzanie brzegowe zamyka pętle czasu rzeczywistego lokalnie, podczas gdy chmura zajmuje się analityką długoterminową. Niezależnie od mieszanki rozwiązania IIoT muszą łączyć IT z OT i zachować interoperacyjność w trudnych warunkach: sieć ma przesyłać dane niezawodnie mimo ciepła, zakłóceń, zaników zasilania i wszystkiego, co jeszcze rzuci w nią zakład.
Dlaczego to takie trudne
Trudne nie są kable ani protokoły. Trudna jest rzeczywistość operacyjna.
Sprzęt z lat 90.
Typowy europejski producent ma na hali maszyny z lat dziewięćdziesiątych. PLC działa, producenta już nie ma, protokół nie jest udokumentowany. Platformy komunikacyjne zarabiają na siebie właśnie tym, że mają sterowniki do takich sierot: linia zostaje w ruchu, a warstwa danych modernizuje się wokół niej.
Podział IT/OT
IT optymalizuje pod poufność i cykle poprawek. OT pod dostępność i pięcioletni zakaz zmian. Obie strony mają rację na swoim terenie i obie się mylą, kiedy przenoszą swój podręcznik przez firewall. Udane projekty traktują to jako problem koordynacji, nie technologii.
Warunki na hali
Szafa sterownicza w hucie pracuje w 50 °C, przy zakłóceniach, które w kilka tygodni wykańczają przełącznik klasy konsumenckiej. Spora część projektów IIoT nie upada dlatego, że architektura była zła, tylko dlatego, że sieć zaprojektowano jak dla biura.
Ekspozycja na ataki
Każde urządzenie obiektowe z adresem sieciowym poszerza powierzchnię ataku, a klienci coraz częściej to audytują. Era, w której izolacja fizyczna uchodziła za strategię bezpieczeństwa, skończyła się mniej więcej wtedy, gdy przestała być prawdziwa.
Koszt błędu jest konkretny: przestoje, zezłomowane partie, spóźnione dostawy i przegrane przetargi częściej, niż ktokolwiek przyzna, prowadzą do warstwy komunikacji, której nikt porządnie nie zaprojektował.
Co daje niezawodna łączność w cyfryzacji produkcji
Kiedy dane płyną niezawodnie, przypadki użycia, które uzasadniają inwestycję w cyfrowe rozwiązania dla produkcji, stają się możliwe.
Predykcyjne utrzymanie ruchu zamienia odczyty wibracji, temperatury i prądu we wczesne ostrzeżenia, zastępując serwis w stałych odstępach interwencją według stanu, a lepsze zbieranie danych z podłączonych maszyn poprawia decyzje w utrzymaniu ruchu i produkcji. Badanie Siemensa przypisuje wdrożeniom predykcyjnego utrzymania ruchu spadek nieplanowanych przestojów w dużym zakładzie z 39 godzin miesięcznie w 2019 roku do 27 w 2024 i to główny powód, dla którego łączny koszt przestojów nie wystrzelił, mimo że każda stracona godzina zdrożała.
Monitorowanie produkcji z OEE w czasie rzeczywistym daje kierownikowi zakładu aktualny obraz wydajności zamiast raportu z wczorajszego poranka, odsłania wąskie gardła i przyspiesza przezbrojenia. Optymalizacja procesu staje się mierzalna, bo dane, które ją napędzają, są spójne między maszynami i zakładami.
Ta sama warstwa danych zasila nowsze zastosowania. Cyfrowe bliźniaki, wirtualne repliki fizycznych zasobów, potrzebują łączności w czasie rzeczywistym, żeby odwzorować i symulować pracę. Podłączony monitoring energii obniża rachunki i emisje. Podłączone systemy wizyjne i czujnikowe wychwytują dryf jakości, zanim zamieni się w złom, a podłączone systemy bezpieczeństwa potrafią spowolnić albo zatrzymać automatykę, gdy człowiek wejdzie w wyznaczoną strefę.
Właśnie to ludzie mają na myśli, mówiąc Przemysł 4.0 albo przemysłowy internet rzeczy. Etykieta zmienia się co kilka lat. Wymaganie nie: niezawodny, bezpieczny i niezależny od producenta sposób przenoszenia danych między maszynami, systemami i ludźmi, którzy podejmują decyzje w procesach przemysłowych.
Jak policzyć business case
Business case dla łączności opiera się na trzech liczbach, które dział finansowy może sprawdzić, a nie na wizji technologicznej.
Koszt godziny przestoju. Weź reprezentatywną linię, pomnóż utraconą przepustowość przez marżę na pokrycie, dodaj koszt bezczynnej załogi, ekspresowy transport i kary umowne. Większość zakładów, które robią to porządnie, odkrywa, że realna kwota jest dwa do trzech razy wyższa niż w raporcie utrzymania ruchu, bo koszty pośrednie (złom po restarcie, spadek uzysku przy rozruchu, części z dopłatą) nigdy nie trafiają do dziennika przestojów. Jeśli Twoja liczba ląduje w okolicach mediany ABB, czyli 125 000 dolarów za godzinę, nawet skromne ograniczenie liczby incydentów spłaca warstwę łączności kilka razy.
Godziny inżynierskie na ręczne przenoszenie danych. Policz, ile godzin miesięcznie technolodzy, planiści utrzymania ruchu i analitycy spędzają na eksportowaniu, uzgadnianiu i przepisywaniu danych między systemami. W naszych wdrożeniach to zwykle największa ukryta pozycja: średni zakład spalający 200 do 400 godzin inżynierskich miesięcznie na ręczną hydraulikę danych to norma, a robią to najdrożsi i najtrudniejsi do zatrudnienia ludzie, wykonując pracę, którą licencja middleware odwala za ułamek tej kwoty.
Zablokowana inicjatywa. Jeśli program predykcyjnego utrzymania ruchu, analityki jakości albo energii jest już zatwierdzony i utknął na warstwie danych, inwestycja w łączność dziedziczy jego business case. Nie finansujesz nowej wartości; odblokowujesz wartość, którą zarząd już podpisał.
Zsumuj te trzy liczby, a uzasadnienie zwykle pisze się samo. Propozycje dotyczące łączności przegrywają nie przez słabą ekonomię, tylko przez ujęcie projektu jako wydatku na infrastrukturę zamiast jako klucza do zwrotów, do których organizacja już się zobowiązała.
Sekwencja wdrożenia, która działa
Większość porażek w łączności to porażki kolejności. Wzorzec, który działa, jest ten sam w automotive, FMCG i farmacji i składa się z sześciu kroków.
1. Audyt (2–3 tygodnie). Zmapuj to, co naprawdę masz: każdy zasób produkujący dane, jego protokół, właściciela i miejsce, do którego dane trafiają (albo nie). To krok, który większość organizacji pomija, i dlatego ich schematy architektury opisują zakład, który nie istnieje. Wynik: inwentarz zasobów i przepływów danych plus lista niezarządzanych urządzeń, o których nikt nie wiedział, że są w sieci. Bez zatrzymywania produkcji.
2. Architektura (2–4 tygodnie). Wybierz wzorzec docelowy, zanim wybierzesz oprogramowanie. Dla większości producentów wielozakładowych tym wzorcem jest Unified Namespace: jedna, scentralizowana warstwa danych, jedno źródło prawdy dla wszystkich systemów, w której każdy producent i konsument danych podłącza się raz, zamiast utrzymywać integracje punkt–punkt. Tutaj ustal konwencje nazewnictwa i modele danych, bo dorabianie ich po uruchomieniu 10 000 tagów to koszmarna robota. Architekturę docelową trzymaj modułową, żeby nie wpaść w uzależnienie od dostawcy i zostawić miejsce na rozbudowę.
3. Dopasowanie platformy (1–2 tygodnie). Dopiero teraz zrób krótką listę oprogramowania, w oparciu o audyt i architekturę, a nie o demo dostawcy. Sekcja niżej opisuje, czym różnią się główne platformy.
4. Pilot (4–8 tygodni). Jedna linia albo jedno gniazdo, ale zaprojektowane jako wycinek architektury docelowej, nie jako coś do wyrzucenia. Pilot musi sprawdzić konwencje nazewnictwa, model bezpieczeństwa i przekazanie zespołowi, który będzie to utrzymywał, bo właśnie te trzy rzeczy pękają przy skalowaniu. Pilot, który udowadnia tylko, że „dane potrafią płynąć”, nie udowadnia niczego, czego byś już nie wiedział.
5. Skalowanie (6–12 tygodni na zakład). Wdrażaj zakład po zakładzie według szablonów, które zweryfikował pilot. Tu zwraca się wcześniejsza dyscyplina: przy ustalonych konwencjach i modelach każdy kolejny zakład to praca konfiguracyjna, nie projektowa, a zdalna konfiguracja staje się praktycznym sposobem wdrażania i zarządzania urządzeniami w wielu lokalizacjach.
6. Governance (na stałe). Przypisz odpowiedzialność za przestrzeń nazw, cykl życia certyfikatów i zarządzanie zmianą. Łączność nie jest projektem, który się kończy; to warstwa, która przeżyje każdą aplikację zbudowaną na niej.
Zachowaj kolejność, a efektywność operacyjna rośnie, podczas gdy zespół zajmuje się wartością, a nie poprawkami. Pomyl ją (zwykle zaczynając od kroku 3, bo demo dostawcy było przekonujące), a dołączysz do 70 % w czyśćcu pilotaży.
Osiem pytań do dostawcy
Zanim cokolwiek podpiszesz, zadaj je krótkiej liście dostawców. Odpowiedzi oddzielają platformy produkcyjne od laboratoryjnych.
- Które protokoły z naszego audytu obsługujecie natywnie, a które wymagają programowania? Poproś o listę sterowników na piśmie, nie o procent.
- Co się dzieje przy 50 000 tagów w trzech zakładach? Poproś o klienta referencyjnego w tej skali, nie o slajd z benchmarkiem.
- Jak domyślnie wygląda bezpieczeństwo: certyfikaty, szyfrowanie, uwierzytelnianie użytkowników? „Konfigurowalne” to nie to samo co „włączone domyślnie”.
- Co model licencyjny robi przy skalowaniu? Licencje per tag, per sterownik, per serwer i subskrypcja dają zupełnie inne koszty pięcioletnie; modeluj docelowy park, nie pilota.
- Jak obsługujecie nasz stary i osierocony sprzęt? Wymień konkretne PLC z lat 90. z audytu i obserwuj reakcję.
- Jak wyglądają aktualizacje i poprawki po stronie OT? Platforma, której nie da się załatać bez zatrzymania produkcji, nie przejdzie audytu bezpieczeństwa.
- Kto wdraża i kto wspiera o drugiej w nocy? Platforma jest tyle warta, ile integrator i łańcuch wsparcia za nią.
- Jaka jest ścieżka wyjścia? Jeśli na pytanie „jak wyciągniemy nasze modele danych” zapada cisza, kupujesz uzależnienie, nie łączność.
Kepware czy Ignition: jak wybrać platformę
Kategoria oprogramowania, o której tu mowa, to middleware komunikacji przemysłowej. Na rynku są Kepware (Velotic), Ignition (Inductive Automation), HighByte, Cogent DataHub i AVEVA PI System. Dla średnich i dużych producentów budujących architekturę niezależną od dostawcy większość decyzji w praktyce sprowadza się do dwóch platform i to właśnie te dwie TT PSC wdraża bezpośrednio.
Kepware to middleware komunikacyjne w najściślejszym sensie. Tłumaczy ponad 150 protokołów przemysłowych na jeden strumień danych i udostępnia go przez OPC UA, MQTT, REST i bezpośrednie łączniki do chmury. Wygrywa, kiedy priorytetem jest szerokie pokrycie starszego sprzętu, produkcyjny serwer OPC UA i topologia, która skaluje się od pilota na jednym serwerze do wielozakładowej architektury UNS bez przepisywania.
Ignition ma szerszy zakres: łączność plus SCADA, HMI, alarmowanie i raportowanie w jednej platformie, z licencją bez limitu tagów. Wygrywa, kiedy wymaganiem jest jedna platforma do łączności i wizualizacji, zwłaszcza w nowych zakładach albo gdy stara SCADA dojrzała do wymiany.
Uczciwa odpowiedź na pytanie „która” zależy od istniejącego parku. Zakład ustandaryzowany na Allen-Bradley, z czystym podziałem na łączność i SCADA, to zwykle przypadek dla Kepware. Regionalny producent FMCG konsolidujący dostawców w pięciu zakładach to zwykle przypadek dla Ignition. Wiele realnych parków używa obu.
TT PSC jest integratorem i autoryzowanym resellerem Kepware w programie partnerskim Velotic oraz integratorem Inductive Automation na poziomie Gold. Wdrażamy obie platformy w automotive, FMCG, farmacji i produkcji dyskretnej w Wielkiej Brytanii, krajach DACH, Skandynawii, Beneluksie, Francji i Polsce. Rekomendacja, którą klient od nas dostaje, wynika z dopasowania do parku, nie z marży licencyjnej.
Od czego zacząć
Komunikacja przemysłowa to miejsce, w którym większość programów transformacji cyfrowej albo się udaje, albo staje, i rzadko decyduje o tym platforma. Decyduje kolejność: audyt, architektura, dopasowanie platformy, pilot, skalowanie, governance. TT PSC towarzyszy producentom w całej tej sekwencji jako partner doradczy, nie tylko reseller.
Jeśli Twoja inicjatywa cyfrowa albo AI utknęła na warstwie danych, rozmowa zaczyna się od obecnej architektury: co masz, co próbujesz połączyć i gdzie naprawdę jest wąskie gardło. Jeśli planujesz wdrożenie Kepware, nasze usługi licencyjne i wdrożeniowe obejmują pełną drogę od doboru rozmiaru po produkcję. A jeśli działasz w UE i bezpieczeństwo OT jest na Twojej agendzie zgodności, bezpłatny test gotowości na NIS2 zajmuje dziesięć minut i pokazuje, gdzie jesteś.
Komunikacja przemysłowa to zintegrowanie maszyn, czujników, sterowników i systemów informatycznych na hali produkcyjnej tak, żeby dane operacyjne płynęły między nimi niezawodnie i w ustandaryzowanej formie. Obejmuje protokoły, sieci i oprogramowanie pośredniczące, które przenoszą dane z urządzeń do systemów i ludzi podejmujących decyzje.